
Erklärfilm: Wie funktioniert eigentlich ein KI-System?
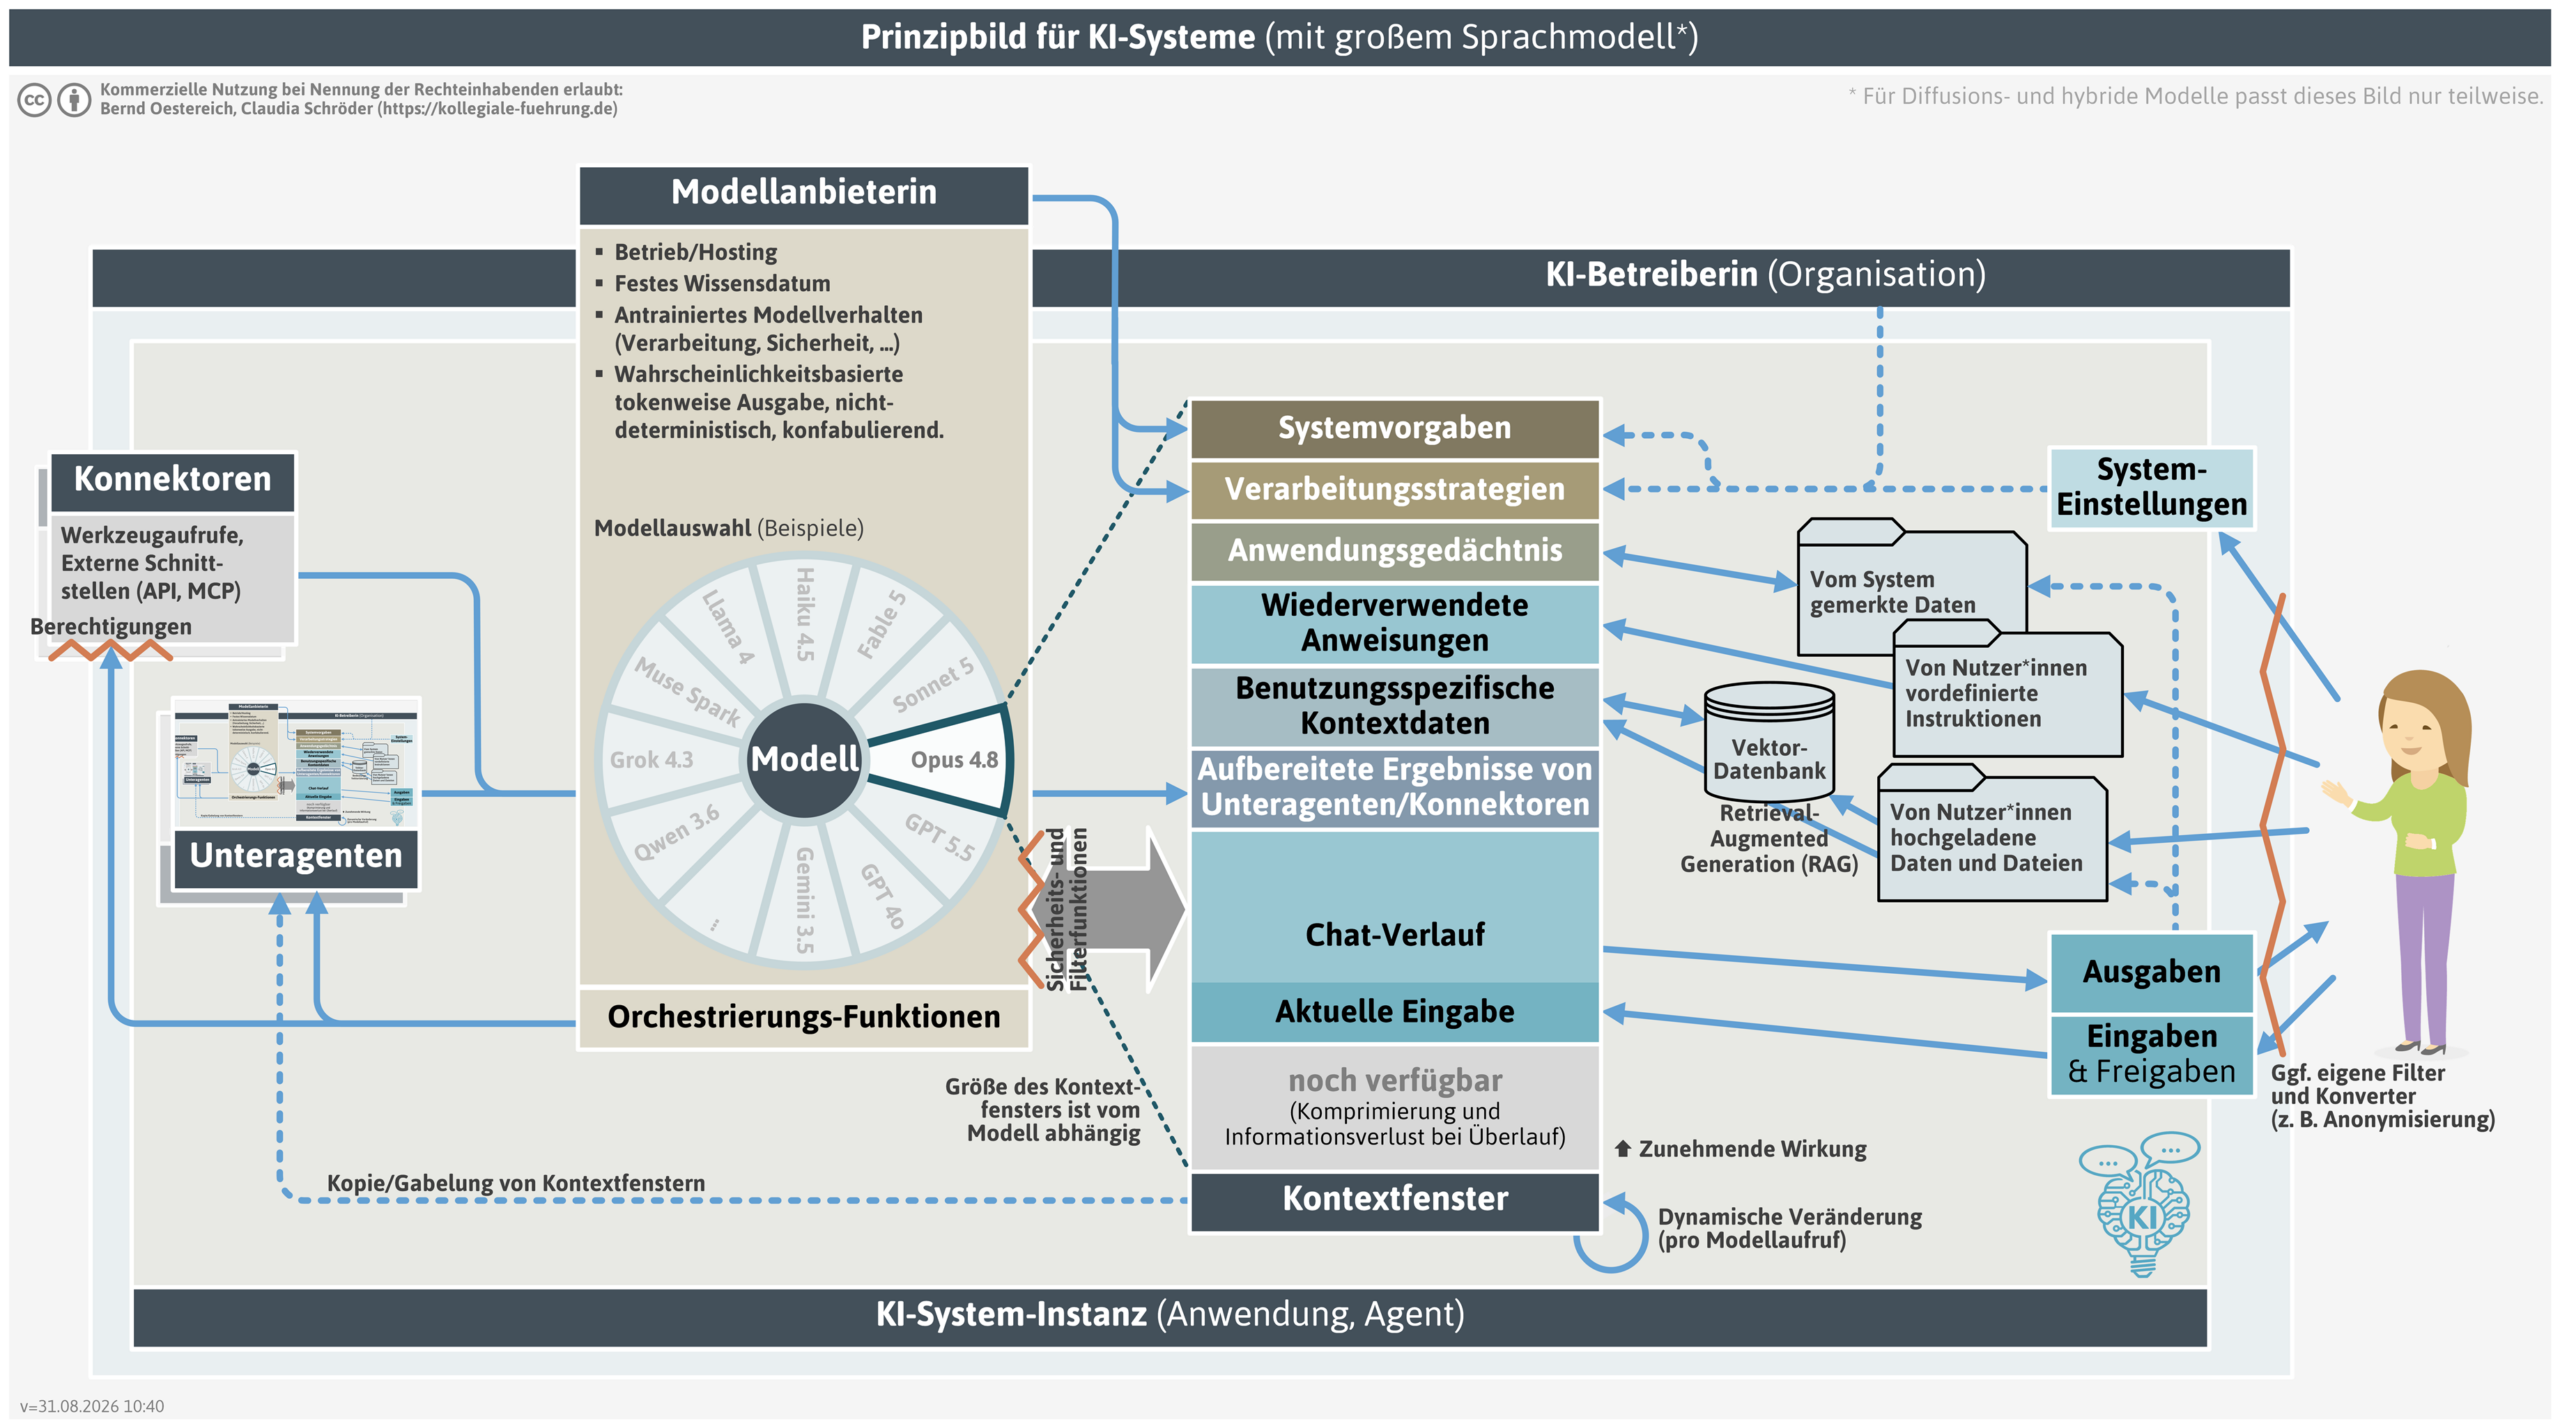
In diesem kurzen Film erkläre ich, wie ein KI-System prinzipiell funktioniert (Modell, KI-System, Kontextfenster, Anwendungsgedächtnis, RAG, Agenten, Konnektoren, Orchestrierung etc.).
Transkript
Herzlich willkommen, mein Name ist Bernd Oestereich und im folgenden erkläre ich, wie ein KI-System eigentlich funktioniert. Zumindest zum Stand vom August 2026.
Beginnen wir bei den Modellen. Bekannte AnbieterInnen von Sprachmodellen sind OpenAI, Anthropic und Google. Diese bieten oft unterschiedliche Sprachmodelle mit unterschiedlichen Fähigkeiten und Stärken an. Die AnbieterInnen haben diese Modelle gebaut und trainiert und hosten diese in einer von ihnen kontrollierten Serverinfrastruktur.
AnwenderInnen benutzen diese Modelle über Ein- und Ausgabefenster, wobei die AnwenderInnen gar nicht direkt mit dem Modell arbeiten, sondern in der Regel mit einem drumherum gebauten KI-System, das die bisherigen Ein- und Ausgaben als Chat sammelt und die Eingaben mit weiteren Informationen anreichert und ein sogenanntes Kontextfenster pflegt.
Im Kontextfenster befinden sich neben dem von den Anwendern gesteuerten Chatverlauf noch viele weitere Informationen, die wir uns nun näher ansehen.
Eine aus Benutzungssicht wichtige Funktion ist die Möglichkeit, eigene Dateien als benutzerdefinierte Kontextdaten hochzuladen. Die Modelle sind mit einem großen Teil des digital verfügbaren Weltwissens trainiert und dieses Wissen endet an einem bestimmten Stichtag. Aktuelle, vor allem aber spezielle Informationen, beispielsweise persönliche oder organisationsspezifische Dokumente und Daten, sind normalerweise kein Teil des trainierten Wissens.
Damit das Sprachmodell mit diesen nutzungsspezifischen Daten arbeiten kann, müssen sie Teil des Kontextfensters werden. Außerdem ist es üblich, wiederzuverwendende Eingaben separat abzulegen. Diese werden dann nur bedarfsweise dazugeladen, beispielsweise um eine spezielle fachliche Expertise einzunehmen, ein bestimmtes Modellverhalten anzufordern oder eine bestimmte Sprache oder Stil zu beschreiben. In Claude werden die wiederverwendbaren Skills genannt, in Chat-GPT gibt es Custom-GPTs und in Gemini heißen sie Gems.
Außerdem pflegen viele KI-Systeme ein eigenes Anwendungsgedächtnis. Das heißt, sie merken sich bestimmte Wünsche, Präferenzen, Gewohnheiten, die sie aus dem Chatverlauf und anderen Elementen des Kontextfensters herauslesen, um spezifischer und effizienter Antworten liefern zu können. Solche KI-Systeme haben auch Mechanismen, dieses Anwendungsgedächtnis zu pflegen, also beispielsweise auf- und umzuräumen. Teilweise sind diese Anwendungsgedächtnisse auch einsehbar und benutzerpflegbar.
Was auch im Kontextfenster liegt, sind Systemvorgaben und Verarbeitungsstrategien. Diese werden größtenteils von den Modellanbietern vorgegeben. Sie beschreiben damit beispielsweise, wie Eingaben verarbeitet werden sollen oder welche Ein- und Ausgaben unzulässig sind. Diese Elemente sind von großer Bedeutung für die Qualität, denn beispielsweise können Konfabulationen, also sogenannte Halluzinationen, minimiert werden, wenn in der Antwort vorgesehene Quellenangaben nochmal in einem Extraverarbeitungsschritt gegengeprüft werden oder ähnliches.
Bevor wir zur nächsten Erklärung kommen, brauchen wir eine weitere Unterscheidung. Wir unterscheiden Modellanbieter wie BetreiberInnen. Auch in der EU-Gesetzgebung, dem EU-AI-Act, existiert diese Unterscheidung. AnbieterInnen sind Firmen wie Google, OpenAI und Anthropic, die diese Modelle trainieren und zur Nutzung anbieten. BetreiberInnen sind Organisationen und Personen, die diese Modelle für sich nutzen. Wenn in deinem Unternehmen KI genutzt wird, dann gilt deine Firma als BetreiberInnen.
BetreiberInnen und NutzerInnen können in begrenzter Weise auch Systemvorgaben und Verarbeitungsstrategien definieren oder konfigurieren. Das Kontextfenster hat aber eine wichtige zu beachtende Eigenschaft wie Größe. Die Größe des Kontextfensters ist begrenzt.
Die Größe der Eingabe, die ein Modell mit einer Anfrage aufnehmen und verarbeiten kann, ist limitiert. Und das hat Konsequenzen. Wenn es voll ist und überläuft, dann werden Informationen abgeschnitten. Das Kontextfenster wird komprimiert. Das heißt, faktisch gelangen nicht mehr alle Informationen mit in die Abfrage.
Entsprechend kann sich die Qualität der Antworten ändern. Die Ergebnisse fühlen sich dann oberflächlicher an oder als hätte das System etwas vergessen oder nicht richtig verstanden. Da der gesamte Chatverlauf Teil des Kontextfensters wird, ist es also nur eine Frage der Zeit.
Dabei werden dann nicht alle Teile des Kontextfensters in gleicher Weise gekürzt. Gekürzt wird vor allem bei den von den BenutzerInnen stammenden Informationen. Deswegen ist es oft hilfreich, die eigene Arbeit in einen neuen Chat mit einem leeren Kontextfenster zu übertragen, wenn man schon eine Weile gearbeitet hat.
Diese Eigenschaft des Kontextfensters ist vor allem auch für die hochgeladenen benutzungsspezifischen Daten relevant. Wenn ich große oder viele Dokumente hochlade, wird das Kontextfenster schon alleine dadurch schnell voll. Deswegen werden gar nicht alle hochgeladenen, vordefinierten oder gemerkten Daten in das Kontextfenster geladen.
Stattdessen werden die Dokumente vorab analysiert, in Bedeutungseinheiten zerlegt und in speziellen Datenbanken als Bedeutungsvektoren gespeichert. Zusammen mit einer Eingabe werden dann gar nicht alle Daten mit hochgeladen, sondern es werden über mathematische Verfahren zunächst die voraussichtlich wirklich bedeutsamen Abschnitte in diesen Dokumenten verwendet und nur diese dann mit in das Kontextfenster übertragen. Über solche Verfahren ist es möglich, auch Datenmengen, die die Größe des Kontextfensters um ein Vielfaches übersteigen, sinnvoll in Anfragen zu berücksichtigen. Hier einfach mal ein Ausschnitt aus dem KI-System Claude Code, in dem man sehen kann, für welche Zwecke wie viel des Kontextfensters genutzt wird.
Mit der Nutzung eines Sprachmodells in der bislang beschriebenen Form lassen sich viele anspruchsvolle und komplexe Aufgaben nicht angemessen bearbeiten. Deswegen arbeiten die meisten Systeme mit verschiedenen Erweiterungen, unter anderem mit Unteragenten. Hierbei wird eine Eingabe beispielsweise zuerst analysiert und in Teilaufgaben zerlegt, die dann an Unteragenten delegiert werden und hinterher wieder zusammengeführt werden. Dies wird auch Orchestrierung genannt. Auch die automatische Verarbeitung über viele verschiedene Schritte wird möglich.
Oft bekommen wir als Anwendende davon wenig mit. Im Prinzip arbeitet dabei jeder Unteragent wieder in der gleichen Weise, wie es unser Bild hier zeigt, also mit eigenen Kontextfenster und so weiter. Nur, dass die Eingaben nicht von einem Menschen stammen, sondern von einem anderen Modell und dass die Ergebnisse auch nicht an einen Menschen zurückliefern, das aufrufende Modell.
Dabei gibt es auch Möglichkeiten, eine Kopie des bestehenden Kontextfensters mitzugeben, damit der bisherige Kontext genutzt werden kann, ohne aber das übergeordnete Kontextfenster dann zu belasten.
Andere Systemerweiterungen sind Konnekturen, also Werkzeugaufrufe über externe Schnittstellen. Beispielsweise, um ins Internet zu gehen, um auf Verzeichnisse und Dateien auf einem PC oder Server zugreifen zu können, ein E‑Mail-Client zu steuern und so weiter.
Dabei werden natürlich verschiedene Sicherheitsaspekte relevant. Zum einen haben die AnbieterInnen Sicherheits- und Filterfunktionen vor ihre Modelle gesetzt, um beispielsweise verbotene Inhalte und Aufträge abzufangen. Zum anderen sind entsprechende Berechtigungen an den Schnittstellen notwendig.
Aber auch die BetreiberInnen, also die KI-nutzenden Organisationen und Personen, brauchen beispielsweise, um personenbezogene oder andere schützenswerte Daten zu anonymisieren, damit die die eigene Organisation nicht verlassen und nicht auf fremden Servern landen.
Noch sicherer ist es, Modelle selbstkontrolliert zu hosten. Aber das ist ein Thema, was ich hier nicht mehr behandle.
So, damit habe ich alle wichtigen Elemente erklärt. Sehr kompakt in einem Bild. Wenn du mehr erfahren möchtest oder ausführliche Texte dazu lesen möchtest, besuche unseren Blog oder Buchinfos auf unserer Homepage kollegiale-führung.de.
Die gezeigte Grafik steht unter einer Creative Commons License und darf frei verwendet werden im speziellen Kontext, solange sie zu gleichen Bedingungen weitergegeben wird und die Urheberschaft bzw. Quelle genannt bleibt.
Die aktuelle Version der Grafik kannst du unter der genannten Adresse herunterladen.
